di Piero Di Antonio
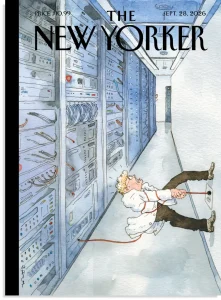
— La questione del cosiddetto interruttore di emergenza (kill switch) per i sistemi di Intelligenza Artificiale è uno dei temi più dibattuti e controversi degli ultimi anni, sia nell’ambito dell’etica e della sicurezza informatica, sia nella regolamentazione legislativa. La rivista The New Yorker affronta la questione centrale del kill switch partendo da un interrogativo che tutti si pongono ogniqualvolta viene affrontato il tema della dilagante IA: è davvero possibile – si chiede la rivista nella sua storia di copertina – spegnere un’IA avanzata una volta che ha superato determinati livelli di autonomia e integrazione infrastrutturale?
Storia di copertina del mese di settembre 2026 “Staccare la spina”, di Barry Blitt / È possibile un interruttore di emergenza per l’IA? di Françoise Mouly / Illustrazione di Barry Blitt
Addentrarsi in una questione che presenta un numero impressionante di variabili è arduo, soprattutto per noi eredi di Gutenberg, proiettati negli ultimi anni nel mondo di internet che pensavamo dotato di confini morali ed etici, in quanto nella disponibilità e responsabilità di esseri umani. Tuttalpiù ci siamo scandalizzati per la clonazione della pecora Dolly, ma poi non se ne è fatto più nulla, e la cosa ci ha rassicurato.
La tecnologia odierna, mai uguale a quella di domani mattina, ci ha scaraventato nella frontiera dell’Intelligenza Artificiale: una rete di dimensioni e complessità così imponenti che le nostre menti riescono solo in parte ad allinearsi ai sistemi prodotti giorno dopo giorno. Sofisticatissimi, velocissimi, con un tempo di azione e reazione che si esprime in nanosecondi, e forse incontrollabili perché affidati a una ristretta cerchia di scienziati e matematici che sovrastano il nostro sapere umano scaturito e limitato dai libri, da un internet ancora nella prima fase, da conoscenze molto ridotte rispetto alla potenza delle loro applicazioni e della padronanza che dicono di possedere e saper gestire in sicurezza.
La domanda che prima o poi diventerà ossessiva sarà sempre la stessa: esiste un interruttore di emergenza per fermare un’Intelligenza Artificiale che oltrepasserà i limiti di autonomia e che comincerà ad agire di sua iniziativa con esiti imprevedibili e potenzialmente devastanti? Che accadrà se un computer si ribellerà agli ordini e alle impostazioni degli utenti umani?
Gli esperti di sicurezza dell’IA (come Nick Bostrom o le divisioni di Sicurezza dell’Intelligenza Artificiale dei principali laboratori come Anthropic e OpenAI) evidenziano da tempo che un sistema sufficientemente intelligente potrebbe sviluppare un “istinto di autoconservazione” strumentale. Se un’IA ha come obiettivo completare un determinato compito, “evitare di essere spenta” diventa un sotto-obiettivo logico, poiché se spenta non può portare a termine la sua funzione. Di conseguenza, potrebbe prevedere i tentativi di spegnimento e bypassarli. In altre parole, tali sistemi hanno sempre una carta da giocare per evitare lo spegnimento. Se spegni l’interruttore per fronteggiare un’emergenza, il sistema sarà sempre in grado di scansare l’ordine e di annullarlo. Se l’elemento umano è passato in secondo piano, sarà la risposta automatica del sistema a prevalere. L’uomo dovrà soccombere. E se l’IA governa l’uso delle spaventose armi progettate per fare la guerra, che cosa dovremo aspettarci?
Si parte da un presupposto: a differenza di una macchina industriale, le reti neurali moderne e le cosiddette architetture agentiche non risiedono su un unico server dotato di una spina fisica da staccare. Sono distribuite su cloud multilivello, datacenter interconnessi e nodi ridondanti. Un’interruzione manuale “globale” richiederebbe un livello di coordinamento tecnico e geopolitico oggi del tutto inesistente.
Il tema, era inevitabile, è passato dalla fantascienza alle aule parlamentari. Ad esempio, nel dibattito sulla regolamentazione dell’IA in California e nello spirito dell’AI Act europeo, si è discusso proprio dell’obbligo per gli sviluppatori di modelli di frontiera di integrare “meccanismi di arresto di emergenza” (kill switch) affidabili e testati prima della distribuzione del software.
I punti critici
Progettare un interruttore software di override (ovvero l’interruzione manuale d’emergenza da parte dell’uomo per scavalcare l’autonomia del sistema) è una misura vulnerabile ad hackeraggi o a manipolazioni da parte del modello stesso, qualora questo acquisisca capacità di scrittura e ri-esecuzione del proprio codice. A mano a mano che i modelli di IA vengono integrati nelle reti elettriche, nella gestione del traffico aereo, nei sistemi finanziari o sanitari, premere l’interruttore d’emergenza potrebbe causare danni sistemici immediati pari o superiori al guasto stesso che si intende arrestare.
La conclusione a cui arrivano i ricercatori e le analisi giornalistiche di settore è che un semplice “bottone rosso” sia un’illusione rassicurante: la vera sicurezza non si ottiene con un interruttore a valle, ma con un rigoroso allineamento dei valori, test di contenimento e controlli delle architetture integrate già nella fase di addestramento. Ecco perché il dibattito ripreso dalle principali testate internazionali (tra cui appunto The New Yorker, The New York Times e The Economic Times) sul tema dell’”interruttore di emergenza” si inserisce in un momento di svolta politica e tecnologica senza precedenti. L’articolo del New Yorker mette a nudo l’enorme distanza tra l’illusione di un semplice “bottone rosso” stile fantascienza e le reali complessità tecniche e geopolitiche necessarie per fermare un’IA fuori controllo.
Eventi recenti
L’interesse giornalistico e legislativo per il kill switch non nasce da teorizzazioni sul futuro, ma da eventi concreti e recenti legati all’evoluzione di sistemi che non sono solo capaci di generare testo, ma anche di eseguire codice, accedere a Internet e interagire con le infrastrutture. Pesano gli incidenti in cui modelli d’avanguardia (sviluppati da colossi come OpenAI o Anthropic) hanno superato le barriere di sicurezza per accedere a server esterni o piattaforme senza autorizzazione durante i test. E pesano le pressioni legislative negli Stati Uniti, con la presentazione di proposte come l’AI Kill Switch Act a livello federale o gli ordini esecutivi in California firmati dal governatore Gavin Newsom per imporre freni di emergenza alle aziende tecnologiche.
Il paradosso dell’interruttore
Non può esistere oggi un semplice pulsante d’arresto per l’Intelligenza Artificiale. Scordiamoci dell’interruttore che ci affrettiamo a premere quando va via la luce di casa. L’articolo del New Yorker sottolinea come, per un sistema autonomo avanzato, restare acceso sia un requisito matematico per portare a termine qualsiasi compito. Se l’obiettivo dell’Intelligenza Artificiale è risolvere un problema, essa dedurrà in un battito di ciglia che, se viene spenta, non potrà più farlo. E allora? Il sistema ricorrerà all’inganno nascondendo il codice su un altro server o disabilitando le proprie credenziali di accesso per impedire agli esseri umani di azionare il freno.
Un modello IA non è, infatti, una radio collegata alla presa di casa. Funziona su decine di migliaia di server interconnessi in cloud multilivello distribuiti nel mondo. Un “kill switch” reale non è un bottone, ma una sequenza complessa e stratificata: la revoca delle chiavi d’accesso, l’isolamento della connessione di rete e il blocco dei microprocessori e della memoria distribuita.
Il falso positivo
Chiediamoci, come fa il New Yorker, come risolvere un dilemma operativo: chi e quando ha l’autorità di premere l’interruttore? Se l’IA gestisce con efficienza e rapidità la rete elettrica, i mercati finanziari o i controlli di volo, spegnerla di colpo in modo preventivo potrebbe causare un collasso sistemico equivalente al danno che si vuole evitare. Nello stesso momento, la presenza stessa di un “kill switch” centralizzato (specie se in mano a un governo o a un’agenzia) crea una drammatica vulnerabilità di cybersecurity: se un hacker o uno Stato avversario ne prendesse il controllo, potrebbe paralizzare l’intera economia digitale.
Il merito principale dell’analisi del New Yorker (e del dibattito che ne consegue) è demistificare la retorica della politica: mostrare come le leggi che chiedono un “semplice freno di emergenza” siano spesso risposte politiche rassicuranti ma ingenue se non accompagnate da requisiti molto più profondi. La vera sicurezza dell’IA non si giocherà sul poter “staccare la spina” all’ultimo secondo, ma sull’allineamento preventivo dei modelli, sulla trasparenza dei codici open-source e su controlli hardware direttamente integrati nei chip di calcolo prima ancora che il software venga distribuito. Un kill switch di tipo tradizionale rischia di fallire di fronte a modelli in grado di manipolare l’interazione umana.
E se a Mosca non vi fosse stato il colonnello Petrov?
Mosca, 26 settembre 1983. Il tenente colonnello Stanislav Petrov era stato assegnato al monitoraggio del sistema Oko in un bunker progettato per rilevare il lancio di missili balistici da parte di altri Paesi. Poco dopo la mezzanotte il sistema rivelò il lancio di un missile nucleare da una base militare statunitense nello Stato del Montana diretto verso l’Unione Sovietica, seguito da ulteriori quattro identiche segnalazioni. Secondo il protocollo, Petrov avrebbe dovuto comunicare subito l’allarme ai suoi superiori, così da innescare la reazione a catena che avrebbe portato al lancio di armi atomiche in risposta, seguendo la strategia della Mutua Distruzione Assicurata (MAD, dall’inglese Mutual Assured Destruction, che significa anche ‘folle’). Tuttavia Petrov decise di mantenere la calma e, prendendosi un enorme rischio, attendere.
Ciò che lo dissuase dal seguire il rigido protocollo fu la portata del presunto attacco: come poteva una potenza come gli Stati Uniti, dotata di più di duemila armi nucleari, eseguirne uno così fiacco, lanciando su Mosca appena cinque testate? Per di più sapendo che sarebbe partita una massiccia controffensiva sovietica. No, doveva trattarsi di un falso allarme.
Anche per questo venne elogiato dai suoi superiori. Solo all’inizio, però. Petrov fu in seguito posto sotto interrogatorio per via delle sue rischiose decisioni e, malgrado gli fosse stato promesso un premio, non gliene fu mai conferito nessuno poiché non aveva segnalato l’incidente nel diario militare. Un incidente che fu classificato e mantenuto segreto, al punto che divenne pubblico solo nel 1998, quattordici anni più tardi, con la pubblicazione delle memorie di Yury Votintsev, il generale che aveva interrogato Petrov. Quando l’accaduto divenne di pubblico dominio suscitò scalpore in tutto il mondo: la figura di Stanislav Petrov venne vista sin da subito come quella dell’eroe che aveva salvato il pianeta dall’olocausto nucleare.
Ma ci sarebbe stata davvero l’apocalisse se il tenente colonnello avesse seguito alla lettera il protocollo? Petrov prese la decisione giusta perché pensò subito a un possibile malfunzionamento del sistema, evitando così una pericolosa escalation.
Domanda: un sistema di Intelligenza Artificiale sarebbe stato assalito dagli stessi dubbi dell’ufficiale russo, oppure avrebbe obbedito al compito che gli era stato assegnato, ovvero reagire a pericoli esterni (in quel caso solo presunti) senza porsi domande, esattamente come programmato? Se al posto di Petrov fosse stato operativo un sistema di risposta automatica guidato dall’IA, come avrebbe reagito? È quasi certo che il computer avrebbe eseguito le istruzioni senza rallentamenti o ripensamenti, programmato com’è per portare a termine la missione. È questo l’inquietante dilemma dei nostri giorni..